DeepSeekV4技术报告阅读笔记
1. 总览
DeepSeek-V4 共有 2 个大小的模型,均为 MoE 语言模型。分别为 DeepSeek-V4-Flash 和 DeepSeek-V4-Pro。两模型的具体参数如下表:
| DeepSeek-V4-Flash | DeepSeek-V4-Pro | |
|---|---|---|
| 总参数量 | 284B | 1.6T |
| 激活参数量 | 13B | 49B |
| 上下文长度 | 1M | 1M |
DeepSeek-V4 在模型架构方面的主要技术路线为:
- 混合 Attention 架构:包含 Compressed Sparse Attention (CSA) 和 Heavily Compressed Attention (HCA),这两种架构帮助提升了在长上下文情形下的推理效率。
- Manifold Constrained Hyper-Connections (mHC):通过扩展表征的维度尝试提升模型的表达能力。
- Muon 优化器:能更快地收敛并提高训练稳定性。
预训练阶段:(还没细看)
后训练阶段:(还没细看)
相比于 DeepSeek-V3.2,V4 在长上下文场景下的效率显著提升。在 1M token 的长上下文 setting 下,与 V3.2 相比,V4 的 single-token inference FLOPs 只有 V3.2 的 27%,KV cache 只有 V3.2 的 10%。论文开源代码网址为 https://huggingface.co/collections/deepseek-ai/deepseek-v4。
2. 模型架构部分
2.1 与 DeepSeek-V3 的异同
- 使用 MoE 架构,采用 DeepSeekMoE 范式
- MoE 负载均衡部分,仍然采用 V3 的思路:auxiliary-loss-free strategy 加上一个针对极端情形的惩罚项 loss。但是 V4 相比 V3 移去了对 routing target nodes 的限制,重新设计了并行策略来保持训练效率。
- V3 前几层使用 dense Transformer,V4 将其中的 dense FFN layer 换成带有 Hash routing 的 MoE layer。
- V4 使用与 V3 相同的 multi-token prediction 策略。
2.1.1 Multi-token Prediction
原本是 DeepSeek-V3 技术报告中的内容,有空我在这里介绍一下。
2.1.2 MoE 负载均衡
也是 DeepSeek-V3 技术报告中的内容,有空我在这里介绍一下。
2.2 mHC
mHC 是 Hyper-Connections (HC) 的改进版本,介绍 mHC 之前,先介绍一下 HC。
HC 希望通过扩展残差数据流的宽度来增加网络的拓扑复杂度,认为这样可以提升模型的表达能力,从而提升性能。比如我们在第 $l$ 层原本有一个残差函数 $\mathcal{F}_l: \mathbb{R}^d \to \mathbb{R}^d$,假设我们第 $l$ 层的输入为 $x_l \in \mathbb{R}^d$,那么我们一般的残差网络的做法是:
\[x_{l+1} = x_l + \mathcal{F}_l(x_l). \tag{1}\]HC 的做法则是尝试将 $\mathbb{R}^d$ 中的特征扩展到 $\mathbb{R}^{n_\mathrm{hc} \times d}$,从而我们第 $l$ 层的特征变成 $X_l = [\mathbf{x}_ {l,1}, \mathbf{x}_ {l,2}, \dots, \mathbf{x}_ {l,n_ \mathrm{hc}}]^T \in \mathbb{R}^{n_ \mathrm{hc} \times d}$。由于 $\mathcal{F}_ l$ 是从 $\mathbb{R}^d$ 到 $\mathbb{R}^d$ 的映射,数据在进入 $\mathcal{F}_ l$ 前需被处理为 $\mathbb{R}^d$ 空间中的数据,在从 $\mathcal{F}_ l$ 中出来后需被处理为 $\mathbb{R}^{n_ \mathrm{hc} \times d}$ 维的数据,于是 HC 中引入 input mapping $A_ l \in \mathbb{R}^{1 \times n_ \mathrm{hc}}$ 与 output mapping $C_ l \in \mathbb{R}^{n_ \mathrm{hc} \times 1}$ 分别在特征进入残差函数之前和之后进行处理。此外,HC还引入了一个 residual transformation $B_ l \in \mathbb{R}^{n_ \mathrm{hc} \times n_ \mathrm{hc}}$ 来对 indentity map 的输出进行变换。HC 的公式为:
\[X_ {l+1} = B_ l X_ l + C_ l \mathcal{F}_ l\left(A_ l X_ l\right).\]其中,$A_ l X_ l = (A_ {l,1} , A_ {l,2}, \dots, A_ {l, n_ \mathrm{hc}}) \cdot (\mathbf{x}_ {l,1}, \mathbf{x}_ {l,2}, \dots, \mathbf{x}_ {l,n_ \mathrm{hc}})^T = \sum_{i=1}^{n_ \mathrm{hc}} A_ {l,i} \mathbf{x}_ {l,i}$ 可以理解为使用 $A_l $ 中的各个元素作为权重,对 $X_ l$ 各行进行加权求和;记 $\mathcal{F}_ l = \mathcal{F}_ l\left(A_ l X_ l\right) \in \mathbb{R}^{1 \times d}$,则 $C_ l \mathcal{F}_ l$ 为 $n_ \mathrm{hc} \times d$ 的矩阵,其中第 $i$ 行为 $C_ {l, i} \mathcal{F}_ l$。
原始的残差连接可以保证 identify 信号可以传递到最后一层,即:
\[x_ L = x_ {L-1} + \mathcal{F}_ {L-1}(x_ {L-1}) = \cdots = x_ l + \sum_ {i=l}^{L-1} \mathcal{F}_ i(x_ i),\]其中 $L > l$。可以看到,即使传输到第 $L$ 层,第 $l$ 层的信号 $x_l$ 仍然被保持。而 identity mapping 给出的信号 $x_l$ 并没有随着层数的加深而消失,这一点看起来正好符合 resnet 的设计初衷。然而,对于 HC,通过递推可以得到:
\[X_ L = \left(\prod_{i=1}^{L-l} B_ {L-i}\right)X_ l + \sum_{i=l}^{L-1}\left(\prod_{j=1}^{L-1-i} B_ {L-j}\right)C_i \mathcal{F}_ i(A_ i X_ i).\]可以看到,第一项为 $\left(\prod_{i=1}^{L-l} B_ {L-i}\right)X_ l$ 而不是 $X_ l$,已经不再是 identity mapping 了,这一点实际上已经有些背离了 residual network 的设计初衷了。
在实验中,mHC作者 也发现 HC 的训练并不稳定,比如 mHC 论文中就贴出了这样的实验结果图:
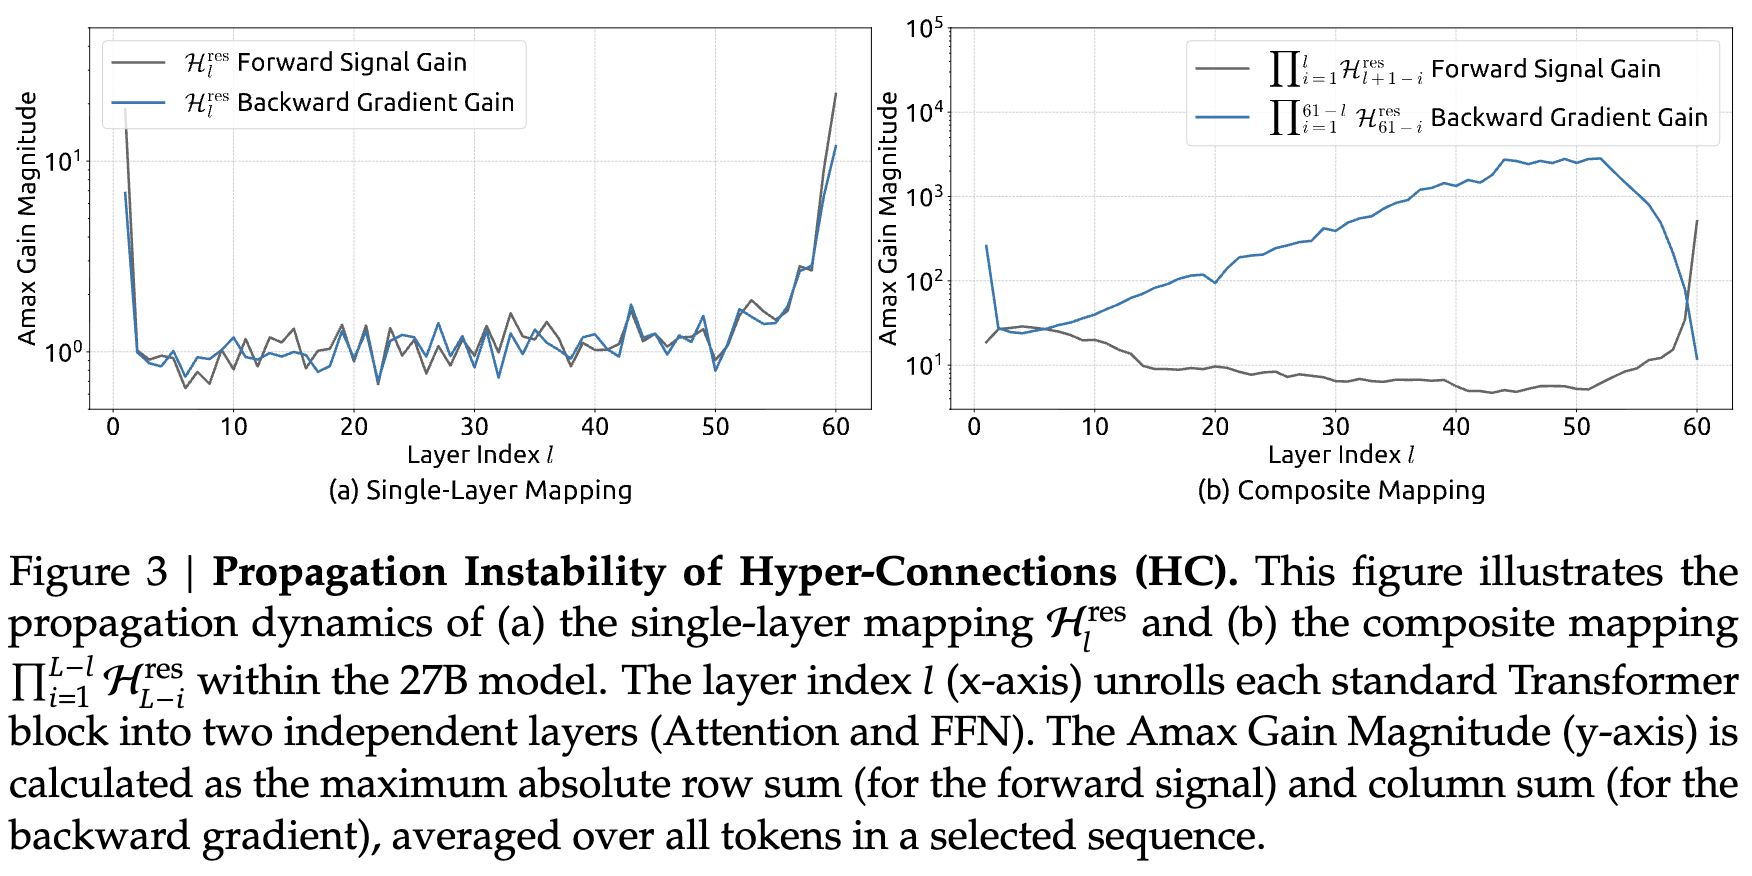
图中的 $\mathcal{H}_ l^\mathrm{res}$ 就对应此处的 $B_ l$,此处为了与 DeepSeekV4 符号保持一致选择使用 DeepSeekV4 的符号。左图画出了各层的 Amax Gain Magnitude,对于 forward 过程,Amax Gain Magnitude 就是 $B_ l$ 的各个行和的绝对值的最大值,即 $\mathrm{AGM}_ \mathrm{forward} (B_ l) = \underset{1 \le i \le n_ \mathrm{hc}}{\max} \vert \sum_ {j=1}^\mathrm{n_ \mathrm{hc}} B_ {l,ij} \vert$;对于 backward 过程,Amax Gain Magnitude 就是 $B_ l$ 的各个列和的绝对值的最大值,即 $\mathrm{AGM}_ \mathrm{forward} (B_ l) = \underset{1 \le j \le n_ \mathrm{hc}}{\max} \vert \sum_ {i=1}^\mathrm{n_ \mathrm{hc}} B_ {l,ij} \vert$。为什么这么定义呢?考虑 $Y = WX$,其中 $X = [\mathbf{x}_ 1^T; \mathbf{x}_ 2^T; \dots; \mathbf{x}_ n^T] \in \mathbb{R}^{n \times d}$, $W = [\mathbf{w}_ 1^T; \mathbf{w}_ 2^T; \dots; \mathbf{w}_ m^T] \in \mathbb{R}^{m \times n}$, $Y = [\mathbf{y}_ 1^T; \mathbf{y}_ 2^T; \dots; \mathbf{y}_ m^T] \in \mathbb{R}^{m \times d}$。
- 对于 forward pass:若将 $X$ 的每一行理解成一个表征,那么 $Y$ 的第 $i$ 行可以视为 $X$ 的各行的加权和,其中各行的权重由 $W$ 的第 $i$ 行的各元素值确定。即 $\mathbf{y}_ i^T = \sum_ {j=1}^n \mathbf{w}_ {ij} \mathbf{x}_ j^T$。因此,$\vert \sum_ {j=1}^n \mathbf{w}_ {ij}\vert$ 的值一定程度上反映了 $W$ 将 $X$ 各行的信号放大了多少倍得到的 $\mathbf{y}_ i^T$。考虑极端情况,若 $X$ 各行相等,均为 $\mathbf{x}^T$,则 $\Vert \mathbf{y}_ i \Vert = \vert \sum_ {j=1}^n \mathbf{w}_ {ij}\vert \cdot \Vert \mathbf{x} \Vert$,故特征 $\mathbf{y}_ i$ 的 scale 被放大了 $\vert \sum_ {j=1}^n \mathbf{w}_ {ij}\vert$ 倍。于是 $\mathrm{AGM}_ \mathrm{forward} (W)$ 可以一定程度上刻画 $Y$ 中各行特征相对于 $X$ 中各行特征被放大的最大倍数。
- 对于 backward pass:若 $L$ 为 loss 值,易知 $\frac{dL}{dX} = W^T \cdot \frac{dL}{dY}$。因此 $\mathrm{AGM}_ \mathrm{backward} (W) = \mathrm{AGM}_ \mathrm{forward} (W^T)$ 刻画了 backward 过程中 $W$ 对梯度的放大倍数。
因此,上述图中用 $\mathrm{AGM}(B_ l)$ 刻画 $B_ l$ 对信号(forward 信号与 backward 信号)传播的 scale 的影响。从图(a)中可以看出,只跨一层时 HC 并不会对信号产生放大效应,信号的传播比较平稳;但是由图(b)可知,当层数累积起来之后,HC 会放大 identity map 那条路径上的信号。
基于上述观察,mHC 文章指出,既然 $\left(\prod_{i=1}^{L-l} B_ {L-i}\right)$ 会放大信号,那么我们就对其进行限制,使其无法放大信号,于是选择增加约束 $\left(\prod_{i=1}^{L-l} B_ {L-i}\right) \in \mathcal{M}_ {n_ \mathrm{hc}}$,其中:
\[\mathcal{M}_ n := \left\{ M \in \mathbb{R}^{n \times n} \mid M \mathbf{1}_ n = \mathbf{1}_ n,\; \mathbf{1}_ n^{\top} M = \mathbf{1}_ n^{\top},\; M \geq 0 \right\} \tag{2}\]为所有 $n \times n$ 的 doubly stochastic matrices(即各行和以及各列和均为1)所组成的空间,也被称为 Birkhoff polytope。$\mathcal{M}_ n$ 有一个很好的性质:对乘法封闭。即如果 $A, B \in \mathcal{M}_ n$,那么有 $AB \in \mathcal{M}_ n$。这也意味着,我们不必限制 $\left(\prod_{i=1}^{L-l} B_ {L-i}\right) \in \mathcal{M}_ {n_ \mathrm{hc}}$,只需对各个 $B_ l$ 限制 $B_ l \in \mathcal{M}_ {n_ \mathrm{hc}}$ 即可。(既然要保证 identity map 的性质,为何不直接令各个 $B_ l = I$?这不是最能直接保证恒等映射的方式吗)
mHC 选择动态地参数化 $A_ l, B_ l, C_ l$,这里的“动态”指的是不单纯地直接将他们设置成可学习的参数,而是让它们与输入特征 $X_ l$ 有关(不过我还没理解到为什么要这样做,是否有一些设计哲学在里面?如果有谁知道,欢迎发邮件讨论)。文章的参数化选择如下:给定输入 $X_ l \in \mathbb{R}^{n_ \mathrm{hc} \times d}$,首先将其压缩成向量然后再进行 normalization:$\hat{X}_ l = \mathrm{RMSNorm}(\mathrm{vec}(X_ l)) \in \mathbb{R}^{1 \times n_ \mathrm{hc} d}$。然后使用 HC 类似的方式给出无约束的 raw parameters $\tilde{A}_ l \in \mathbb{R}^{1 \times n_ \mathrm{hc}}, \tilde{B}_ l \in \mathbb{R}^{n_ \mathrm{hc} \times n_ \mathrm{hc}}$,以及 $\tilde{C}_ l \in \mathbb{R}^{n_ \mathrm{hc} \times 1}$:
\[\begin{align} \tilde{A}_ l &= \alpha_ l^{\mathrm{pre}} \cdot \left(\hat{X}_ l W_ l^{\mathrm{pre}}\right) + S_ l^{\mathrm{pre}}, && \tag{3} \\ \tilde{B}_ l &= \alpha_ l^{\mathrm{res}} \cdot \operatorname{Mat}\left(\hat{X}_ l W_ l^{\mathrm{res}}\right) + S_ l^{\mathrm{res}}, && \tag{4} \\ \tilde{C}_ l &= \alpha_ l^{\mathrm{post}} \cdot \left(\hat{X}_ l W_ l^{\mathrm{post}}\right)^{\top} + S_ l^{\mathrm{post}}. && \tag{5} \end{align}\]其中 $W_ l^\mathrm{pre}, W_ l^\mathrm{post} \in \mathbb{R}^{n_ \mathrm{hc}d \times n_ \mathrm{hc}}$,以及 $W_ l^\mathrm{res} \in \mathbb{R}^{n_ \mathrm{hc}d \times n_ \mathrm{hc}^2}$ 为可学习参数,他们负责生成 raw parameters 的动态部分;$\operatorname{Mat}(\cdot)$ 算子将一个 $1 \times n_ \mathrm{hc}^2$ 的向量 reshape 成一个 $n_ \mathrm{hc} \times n_ \mathrm{hc}$ 的矩阵;$S_ l^\mathrm{pre} \in \mathbb{R}^{1 \times n_ \mathrm{hc}}, S_ l^\mathrm{post} \in \mathbb{R}^{n_ \mathrm{hc} \times 1}, S_ l^\mathrm{res} \in \mathbb{R}^{n_ \mathrm{hc} \times n_ \mathrm{hc}}$ 为可学习的静态 bias;$\alpha_ l^\mathrm{pre}, \alpha_ l ^\mathrm{res}, \alpha_ l^\mathrm{post} \in \mathbb{R}$ 为可学习的 gating factors,初始化为很小的值。此处 mHC 的选择与 HC 略有不同,HC 直接用矩阵形式的 $X_ l$ 进行 RMSNorm 并参与参数化,而 mHC 却先将 $X_ l$ 压缩成向量之后再进行后续操作,这是为什么呢?
有了 raw parameters $\tilde{A}_ l, \tilde{B}_ l, \tilde{C}_ l$ 之后,论文再对这些 raw parameters 施加约束(为了保证数值稳定性)得到最终的参数 $A_ l, B_ l, C_ l$。对于 $A_ l, C_ l$,mHC 施加的约束是非负和有界,于是采用 sigmoid 函数作用于它们:
\[\begin{align} A_ l &= \sigma\left(\tilde{A}_ l\right), && \tag{6} \\ C_ l &= 2\sigma\left(\tilde{C}_ l\right). && \tag{7} \end{align}\]其中 $\sigma(\cdot)$ 是 Sigmoid 函数。这里 mHC 的选择也与 HC 不同,HC 没有加非负和有界的约束,而是直接在 (3)-(5) 式内部的 $X_l W$ 项外面套了一个 tanh 激活函数。对于 $B_ l$,我们要将其约束在 $\mathcal{M}_ {n_ \mathrm{hc}}$ 中。要达成这一点,论文采用 Sinkhorn-Knopp algorithm。该算法首先令 $M^{(0)} = \exp(\tilde{B}_ l)$,注意,这里 exp 是逐元素做指数操作,而不是矩阵的指数操作,需要这么做是因为 Sinkhorn-Knopp algorithm 要求初始矩阵是正的。然后执行
\[M^{(t)} = \mathcal{T}_ r\left( \mathcal{T}_ c\left( M^{(t-1)} \right) \right), \qquad \tag{8}\]其中,$\mathcal{T}_ r$ 是 row normalization 操作,即让各行元素除以它们的和;$\mathcal{T}_ c$ 是 column normalization。Sinkhorn-Knopp 的结果证明了,当 $t \to \infty$,$M^{(t)}$ 趋近于一个 doubly stochastic matrix。论文中选择了 $t_ {\max} = 20$ 步迭代。
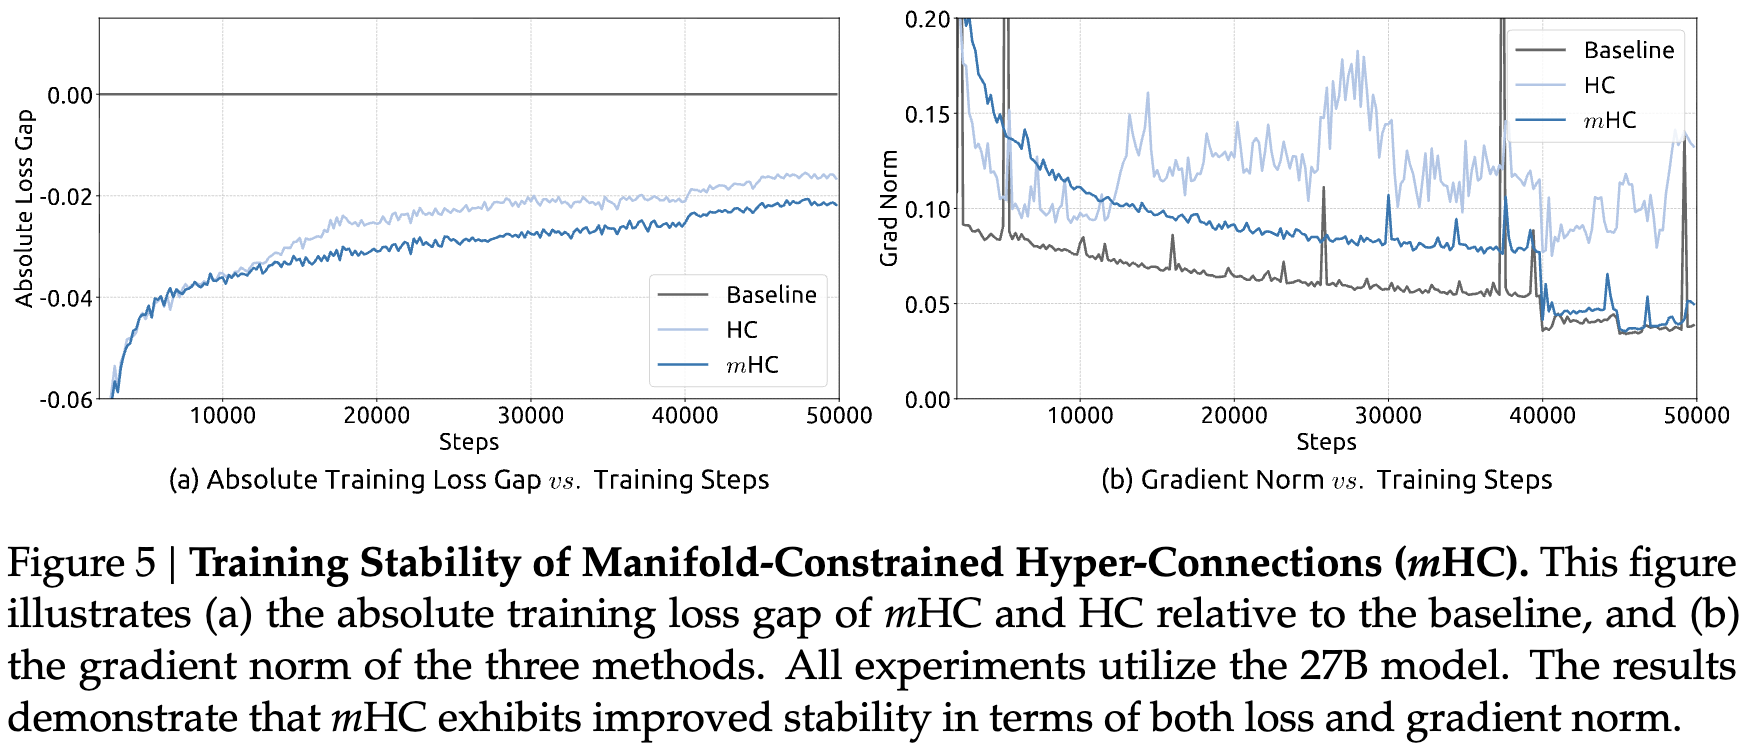
mHC 的论文中的实验结果表明,使用 mHC 确实可以提升训练的稳定性,降低 loss 值,如下图所示:
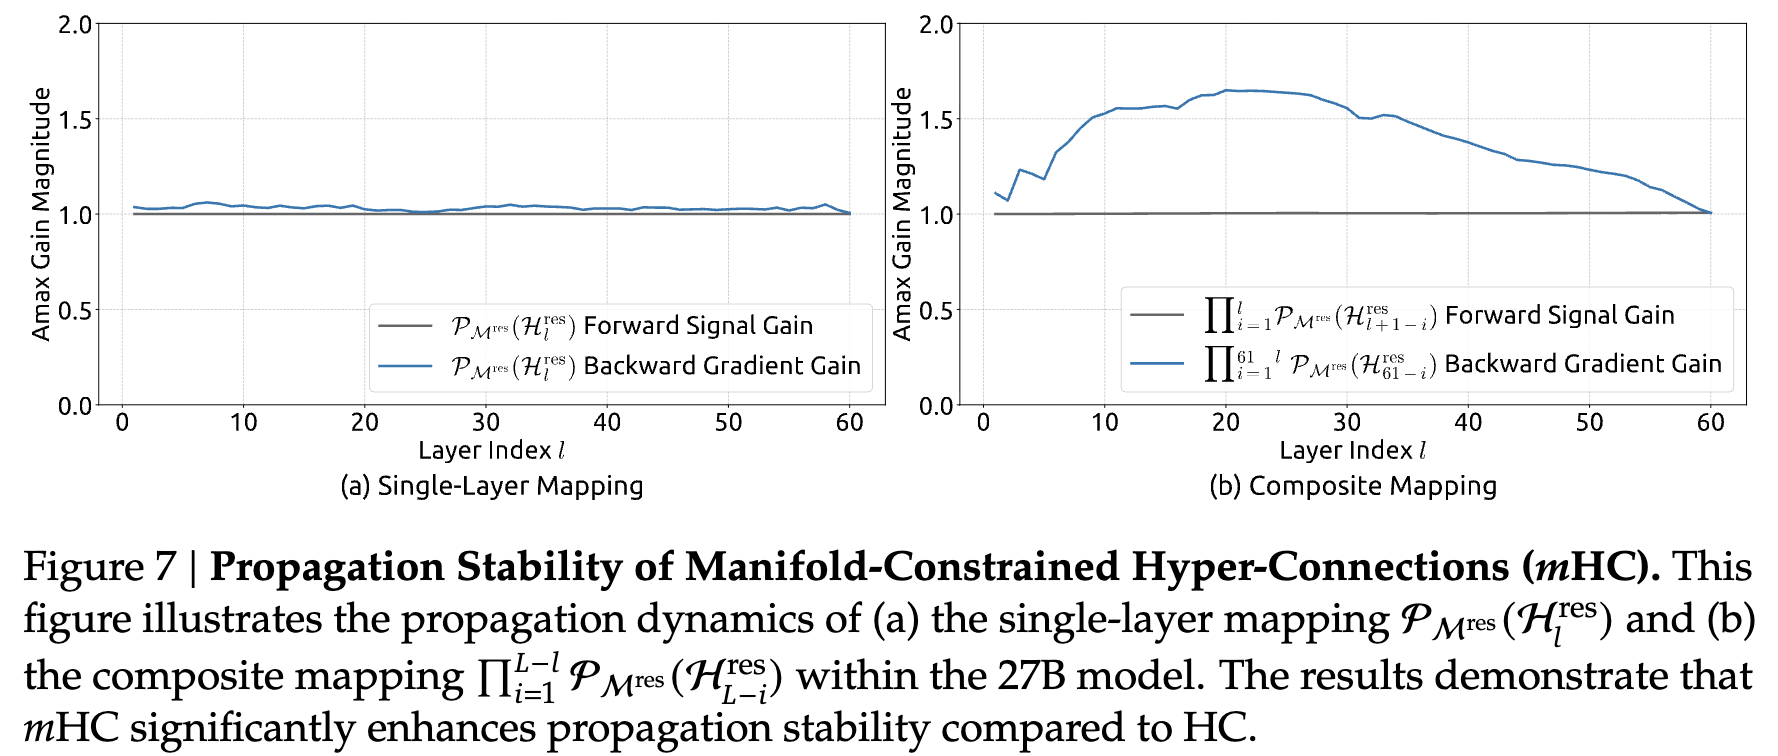
此外,mHC 的实验还表明了 mHC 确实可以让 Amax Gain Magnitude 稳定:
2.3 Compressed Sparse Attention (CSA)
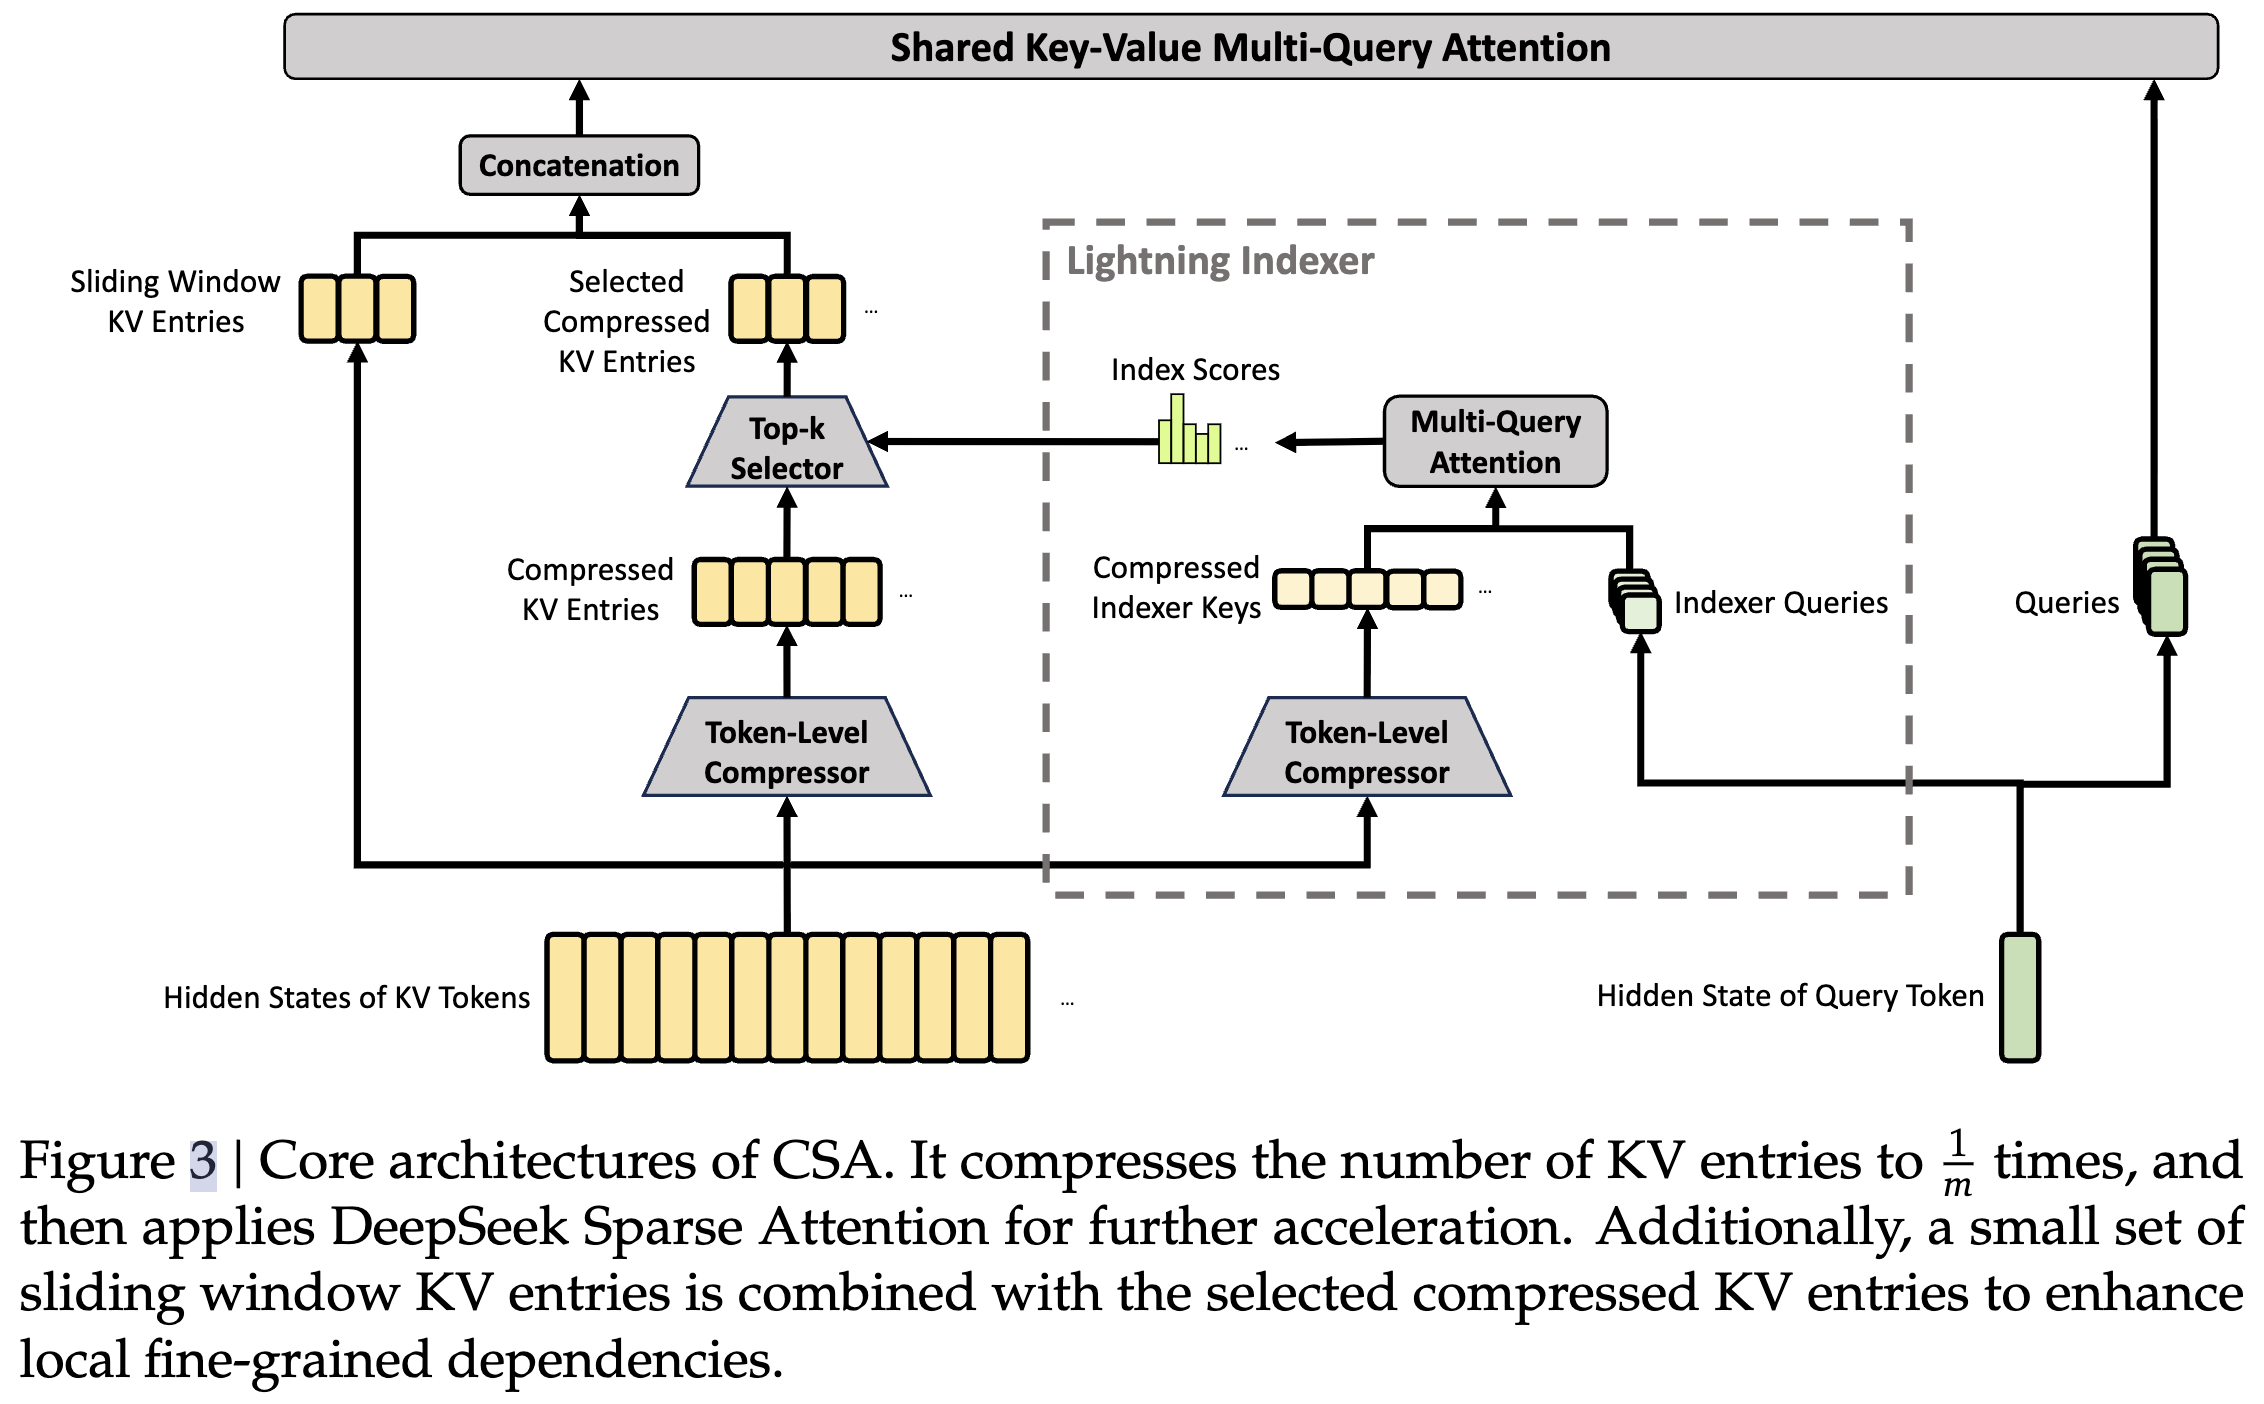
CSA 同时采用了 compression attention 和 sparse attention 的技术:它首先将每 $m$ 个 token 的 KV cache 压缩成一个 compressed KV entry,然后使用 DeepSeek Sparse Attention (DSA, 来自 DeepSeekV3.2) 挑选出 $k$ 个 compressed KV entries 进行 attention 操作。CSA 的结构如图所示:
2.3.1 KV Entries 压缩过程
令 $H \in \mathbb{R}^{n \times d}$ 为 hidden states 序列,其中 hidden state 维度为 $d$,序列长度为 $n$。CSA 首先通过 $H$ 计算两组 KV entries $C^a, C^b \in \mathbb{R}^{n \times c}$ 以及这两组 KV entries 对应的 compression weights $Z^a, Z^b \in \mathbb{R}^{n \times c}$:
\[\begin{align} C^{a} &= H \cdot W^{aKV}, & C^{b} &= H \cdot W^{bKV}, \tag{9} \\ Z^{a} &= H \cdot W^{aZ}, & Z^{b} &= H \cdot W^{bZ}. \tag{10} \end{align}\]其中 $W^{aKV}, W^{bKV}, W^{aZ}, W^{bZ} \in \mathbb{R}^{d \times c}$ 为可训练参数。 此处,$C^a, C^b$ 为两组 KV entries。后续需要将每 $m$ 个 KV entry 压缩成 1 个 KV entry,因此需要对其进行加权求和,而 $Z^a, Z^b$ 就分别用来获取 $C^a, C^b$ 对应的加权系数。
接下来就是 compress 的步骤,对于 $C^a, C^b$ 中的每 $m$ 个 KV entries(也就是每 $m$ 行),要对它们进行加权求和得到1个 KV entry(就是1行),加权系数由 $Z^a, Z^b$ 以及一组可以学习 bias 系数 $B^a, B^b \in \mathbb{R}^{m \times b}$ 确定,最终得到压缩后的 compressed KV entries $C^\mathrm{Comp} \in \mathbb{R}^{\frac{n}{m} \times c}$。对于 $C^\mathrm{Comp}$ 的第 $i$ 行 $C_ i^\mathrm{Comp} \in \mathbb{R}^c$,它是由第 $a$ 组对应的 $m$ 个 KV entries 和第 $b$ 组对应的 $m$ 个 KV entries 共同(一共有 $2m$ 个参与加权求和)进行加权求和得到。为方便起见,此处令 $i$ 从 0 开始计数,即 $i = 0,1,\dots, \frac{n}{m} - 1$。令 $[A, B]$ 表示将矩阵 $A, B$ 沿着列的维度进行堆叠,令 $[A; B]$ 表示将矩阵 $A, B$ 沿着行的维度进行堆叠。于是 $C_ i^\mathrm{Comp}$ 对应的加权系数矩阵为:
\[\left[ S^{a}_ {mi:m(i+1)-1}; S^{b}_ {m(i-1):mi-1} \right] = \operatorname{Softmax}_ {\mathrm{row}} \left( \left[ Z^{a}_ {mi:m(i+1)-1} + B^{a}; Z^{b}_ {m(i-1):mi-1} + B^{b} \right] \right). \tag{11}\]其中 $\operatorname{Softmax}_ {\mathrm{row}}$ 表示沿着行的维度进行 softmax 操作,即 $\operatorname{Softmax}_ {\mathrm{row}}(S)$ 会分别对 $S$ 各列进行 softmax,得到的矩阵的各列的列和为 1。然后再对各行进行加权求和得到 $C_ i^\mathrm{Comp}$:
\[C^{\mathrm{Comp}}_ i = \sum_{j=mi}^{m(i+1)-1} S^{a}_ j \odot C^{a}_ j + \sum_{j=m(i-1)}^{mi-1} S^{b}_ j \odot C^{b}_ j. \tag{12}\]其中 $\odot$ 为 Hadamard product,进行逐元素相乘,$S_ j^a, C_ j^a$ 分别为 $S^a, C^a$ 的第 $j$ 行,$S_ j^b, C_ j^b$ 分别为 $S^b, C^b$ 的第 $j$ 行。注意这里,第 $b$ 组的下标 $i-1$ 比第 $a$ 组的下标 $i$ 少一个,因此当 $i=0$ 时,直接令 $Z^{b}_ {m(i-1):mi-1}$ 的各元素为负无穷,令 $C^{b}_ {m(i-1):mi-1}$ 的各元素为 0,即此时 $b$ 组不参与加权求和。需要注意的是,$C_ i^\mathrm{Comp}$ 的计算需要用到的是 $2m$ 个 KV entries,其中 $m$ 个来自 $a$ 组的第 $i$ 组 $m$ entries,另外 $m$ 个来自 $b$ 组的第 $i-1$ 组 $m$ entries,因此实际上它是包含了 $2m$ 个时刻的信息的,并且用于计算 $C_ i^\mathrm{Comp}$ 的 $b$ 组下标与用于计算 $C_ {i-1}^\mathrm{Comp}$ 的 $a$ 组下标是重叠的。所以 CSA 可以将 KV 序列长度压缩至 $\frac{1}{m}$。这里的 KV cache 中各个 entry 的维度为 $c$ 而不再是 $d$,可以选 $c \ll d$ 来实现与 MLA(见 DeepSeekV3)类似的功能,降低 KV cache 占的空间。
2.3.2 使用 Lightning Indexer (LI) 做 Sparse Selection 过程
在获得 compressed KV entries $C^{\mathrm{Comp}}$ 之后,CSA 应用 DSA 的 lightning indexer 选出 top-$k$ 的 compressed KV entries 来拿与当前 query 做 attention。
Lightning indexer 中有 $n_ h^I$ 个 head,各 head 的 latent dimension 是 $c^I$。这 $n_ h^I$ 个 head 共享一个 K cache $K^\mathrm{IComp} \in \mathbb{R}^{\frac{n}{m} \times c^I}$。对于时刻 $t$ 的 hidden state $h_ t$,这里使用与 MLA 类似的 low rank 方式来产生 indexer queries $\{ q_ {t,1}^I, q_ {t,2}^I, \dots, q_ {t,n_ h^I}^I \}$:
\[\begin{align} c_ t^{Q} &= h_ t \cdot W^{DQ}, \tag{13} \\ \left[ q_ {t,1}^{I}; q_ {t,2}^{I}; \ldots; q_ {t,n_ h^{I}}^{I} \right] = q_ t^{I} &= c_ t^{Q} \cdot W^{IUQ}. \tag{14} \end{align}\]其中,$h_ t \in \mathbb{R}^d$ 为 $t$ 时刻的 hidden state;$c_ t^Q \in \mathbb{R}^{d_ c}$ 为 queries 的 compressed hidden vector。此处 $n_ h^I$ 个 head 的 query 被写到了一起:$q_ t^I$。$W^{DQ} \in \mathbb{R}^{d \times d_ c}$ 和 $W^{IUQ} \in \mathbb{R}^{d_ c \times c^I n_ h^I}$ 分别为 down-projection 矩阵和 up-projection 矩阵。
给定 $t$ 时刻各个 LI head 的 query $\left[q_ {t,1}^{I}; q_ {t,2}^{I}; \ldots; q_ {t,n_ h^{I}}^{I} \right]$ 之后,需要计算第 $s$ 个 compressed block 对于这些 queries 的 index score $I_ {t,s} \in \mathbb{R}$,此处由于不能让 $t$ 时刻的 token 看到 $>t$ 时刻的信息,只在 $s < \lfloor \frac{t}{m} \rfloor$ 对应的 compressed blocks 中做选择(注意,此处不再和 2.3.1 节一样假设时间从 0 时刻开始,而是假设时间从 1 时刻开始)。$I_ {t,s}$ 的计算方式如下:
\[\begin{align} \left[ w_ {t,1}^{I}, w_ {t,2}^{I}, \ldots, w_ {t,n_ h^{I}}^{I} \right] = \mathbf{w}_ t^{I} &= h_ t \cdot W^{w}, \tag{15} \\ I_ {t,s} &= \sum_{h=1}^{n_ h^{I}} w_ {t,h}^{I} \cdot \operatorname{ReLU} \left( q_ {t,h}^{I} \cdot K_ s^{I\mathrm{Comp}} \right). \tag{16} \end{align}\]其中 $\mathbf{w}_ t^I$ 为权重向量,分别为各个 head 赋予对应的权重,它由 $h_ t \cdot W^w$ 得到,所以 权重是由 hidden state $h_ t$ 选择的 ;$W^w \in \mathbb{R}^{d \times n_ h^I}$ 为可学习的矩阵。于是我们可以得到 $t$ 时刻前的 compressed KV entries 对应的 score 的集合 $I = \left\{ I_ {t,s} \vert 1 \le s < \lfloor \frac{t}{m} \rfloor \right\}$(怎么感觉这里应该可以等于 $\lfloor \frac{t}{m} \rfloor$ 因为感觉每个 block 内的最后一个时刻的 query 是可以看到当前 block 里面的信息的),然后使用一个 top-$k$ selector 取获得 score 属于 top-$k$ 的 compressed KV entries $C_ t^\mathrm{SprsComp}$ 用来做 core attention:
\[C_ t^{\mathrm{SprsComp}} = \left\{ C_ s^{\mathrm{Comp}} \;\middle|\; I_ {t,s} \in \operatorname{Top}\text{-}k \left(I\right) \right\}. \tag{17}\]注意,这里有一个细节,对于时刻 $t = 1, 2, \dots$ 如果 $pm < t \le (p+1)m$(其中 $p \ge 0$),则由于不能让 $t$ 时刻的 query 看见 $t+1$ 时刻的 key 和 value,会选择将第 $p+1$(从 1 开始计数)个 compressed KV entry 丢掉,不参与 core attention。此时 DSA 模块必定会丢失时刻 $pm+1, \dots, t$ 的 key 和 value 信息,会损失局部信息。一般来说接近时刻 $t$ 的局部信息应该会比较重要,因此,为了避免因此来带的局部信息确实,DeepSeekV4 选择除了做 DSA 之外,再加一个窗口大小为 $n_ \mathrm{win}$ 的 sliding window attention (SWA) 来处理 uncompressed KV entries,这样就可以捕获时刻 $t$ 附近的局部信息。一般来说,得让 $n_ \mathrm{win} \ge m$ 才行,不然窗口大小可能无法覆盖丢失的局部信息。
2.3.3 Shared Key-Value Multi-Query Attention (MQA)
假设有 $n_ h$ 个 query heads,一般的 multi-head attention 会对应地有 $n_ h$ 个 key heads 和 $n_ h$ 个 value heads。而 MQA 则是让这 $n_ h$ 个 query heads 共用同一个 key head 和 value head,这样做能将 KV cache 减少 $n_ h$ 倍。此处则是使用 $C_ t^{\mathrm{SprsComp}}$ 中的 KV entries 同时作为 attention key 和 attention value,相当于只有一个 KV head。具体来说,对于 query token $t$,首先从 compressed latent vector $c_ t^Q$ 中产生 attention queries $\{ q_ {t,1}, q_ {t,2}, \dots, q_ {t,n_ h}\}$
\[\left[ q_ {t,1}; q_ {t,2}; \ldots; q_ {t,n_ h} \right] = q_ t = c_ t^{Q} \cdot W^{UQ}. \tag{18}\]其中 $W^{UQ} \in \mathbb{R}^{d_ c \times c n_ h}$ 是 querie 的 up-projection 矩阵。注意这里与 (14) 式中 indexer queries 使用的是同一个 latent vector $c_ t^{Q}$(我之前还在想为什么要用 latent vector,反正 query 也没有 cache,也没必要做类似于 MLA 的操作,原来是为了复用 indexer head 的 latent vector),只是它们的 up-projection 矩阵不同。于是可以直接在 $\{ q_ {t,i} \}$ 和 $C_ t^{\mathrm{SprsComp}}$ 上使用 MQA 算子:
\[o_ {t,i} = \operatorname{CoreAttn} \left( \mathrm{query}=q_ {t,i}, \; \mathrm{key}=C_ t^{\mathrm{SprsComp}}, \; \mathrm{value}=C_ t^{\mathrm{SprsComp}} \right). \tag{19}\]其中 $o_ {t,i} \in \mathbb{R}^c$ 是第 $i$ 个 core attention head 在第 $i$ 个 token 上的输出。
Grouped Output Projection. 在 DeepSeekV4 的设定中,$c n_ h$ 是很大的,因此直接对 $[ o_ {t,1}; o_ {t,2}; \dots ; o_ {t,n_ h} ] = o_ t \in \mathbb{R}^{c n_ h} $ 使用线性投影的计算开销很大。为此,论文设计了一种 grouped output projection 策略。首先将 $n_ h$ 个 head 的输出分成 $g$ 组,然后对第 $i$ 组的 output $o_ {t,i}^G \in \mathbb{R}^{c \frac{n_ h}{g}}$,将其投影到 $d_ g$ 维空间中,得到 $o_ {t,i}^{G’} \in \mathbb{R}^{d_ g}$,其中 $d_ g < c \frac{n_ h}{g}$,否则这个操作就没意义了。最后将 $[o_ {t, 1}^{G’}; \dots, o_ {t, g}^{G’}] \in \mathbb{R}^{d_ g g}$ 拼到一起投影到 $\mathbb{R}^d$ 上得到最终 attention output $\hat{o}_ t \in \mathbb{R}^d$。感觉一句话来说就是将 $\mathbb{R}^{c n_ h}$ 先投影到 $\mathbb{R}^{d_ g g}$,再从 $\mathbb{R}^{d_ g g}$ 投影到 $\mathbb{R}^{d}$。按乘法计算个数来看:
- 将 $\mathbb{R}^{c n_ h}$ 先投影到 $\mathbb{R}^{d_ g g}$ 相当于做了 $g$ 组 $\mathbb{R}^{c \frac{n_ h}{g}} \to d_ g$ 的乘法,共 $g \cdot c \frac{n_ h}{g} \cdot d_ g = c n_ h d_g$ 次乘法;从 $\mathbb{R}^{d_ g g}$ 投影到 $\mathbb{R}^d$ 共有 $d_ g g d$ 次乘法。共 $c n_ h d_g + d_ g g d = d_ g (c n_ h + gd)$ 次乘法。
- 直接从 $\mathbb{R}^{c n_ h}$ 投影到 $\mathbb{R}^{d}$ 要做 $c n_ h d $ 次乘法。
- 两者相差 $c n_ h d - d_ g (c n_ h + gd) = c n_ h (d - d_ g) + d_ g g d > d_ g g (d - d_ g) + d_ g g d = d_ g g (2d - d_ g)$。所以似乎还得让 $2d - d_ g > 0$,即 $d_ g < 2d$ 才能节省乘法个数(除非论文想表达的负担是指显存的负担而不是计算量的负担)。
2.4 Heavily Compressed Attention (HCA)
HCA 极大地降低了在长上下文情景下的 attention 计算开销,它做了比较极端的压缩,将每 $m’$ 个 token 的 KV cache 压缩成一个 compressed KV entry,其中 $m’ \gg m$。DeepSeekV4 同时使用了 CSA 和 HCA,极大地提升了模型的长上下文能力。
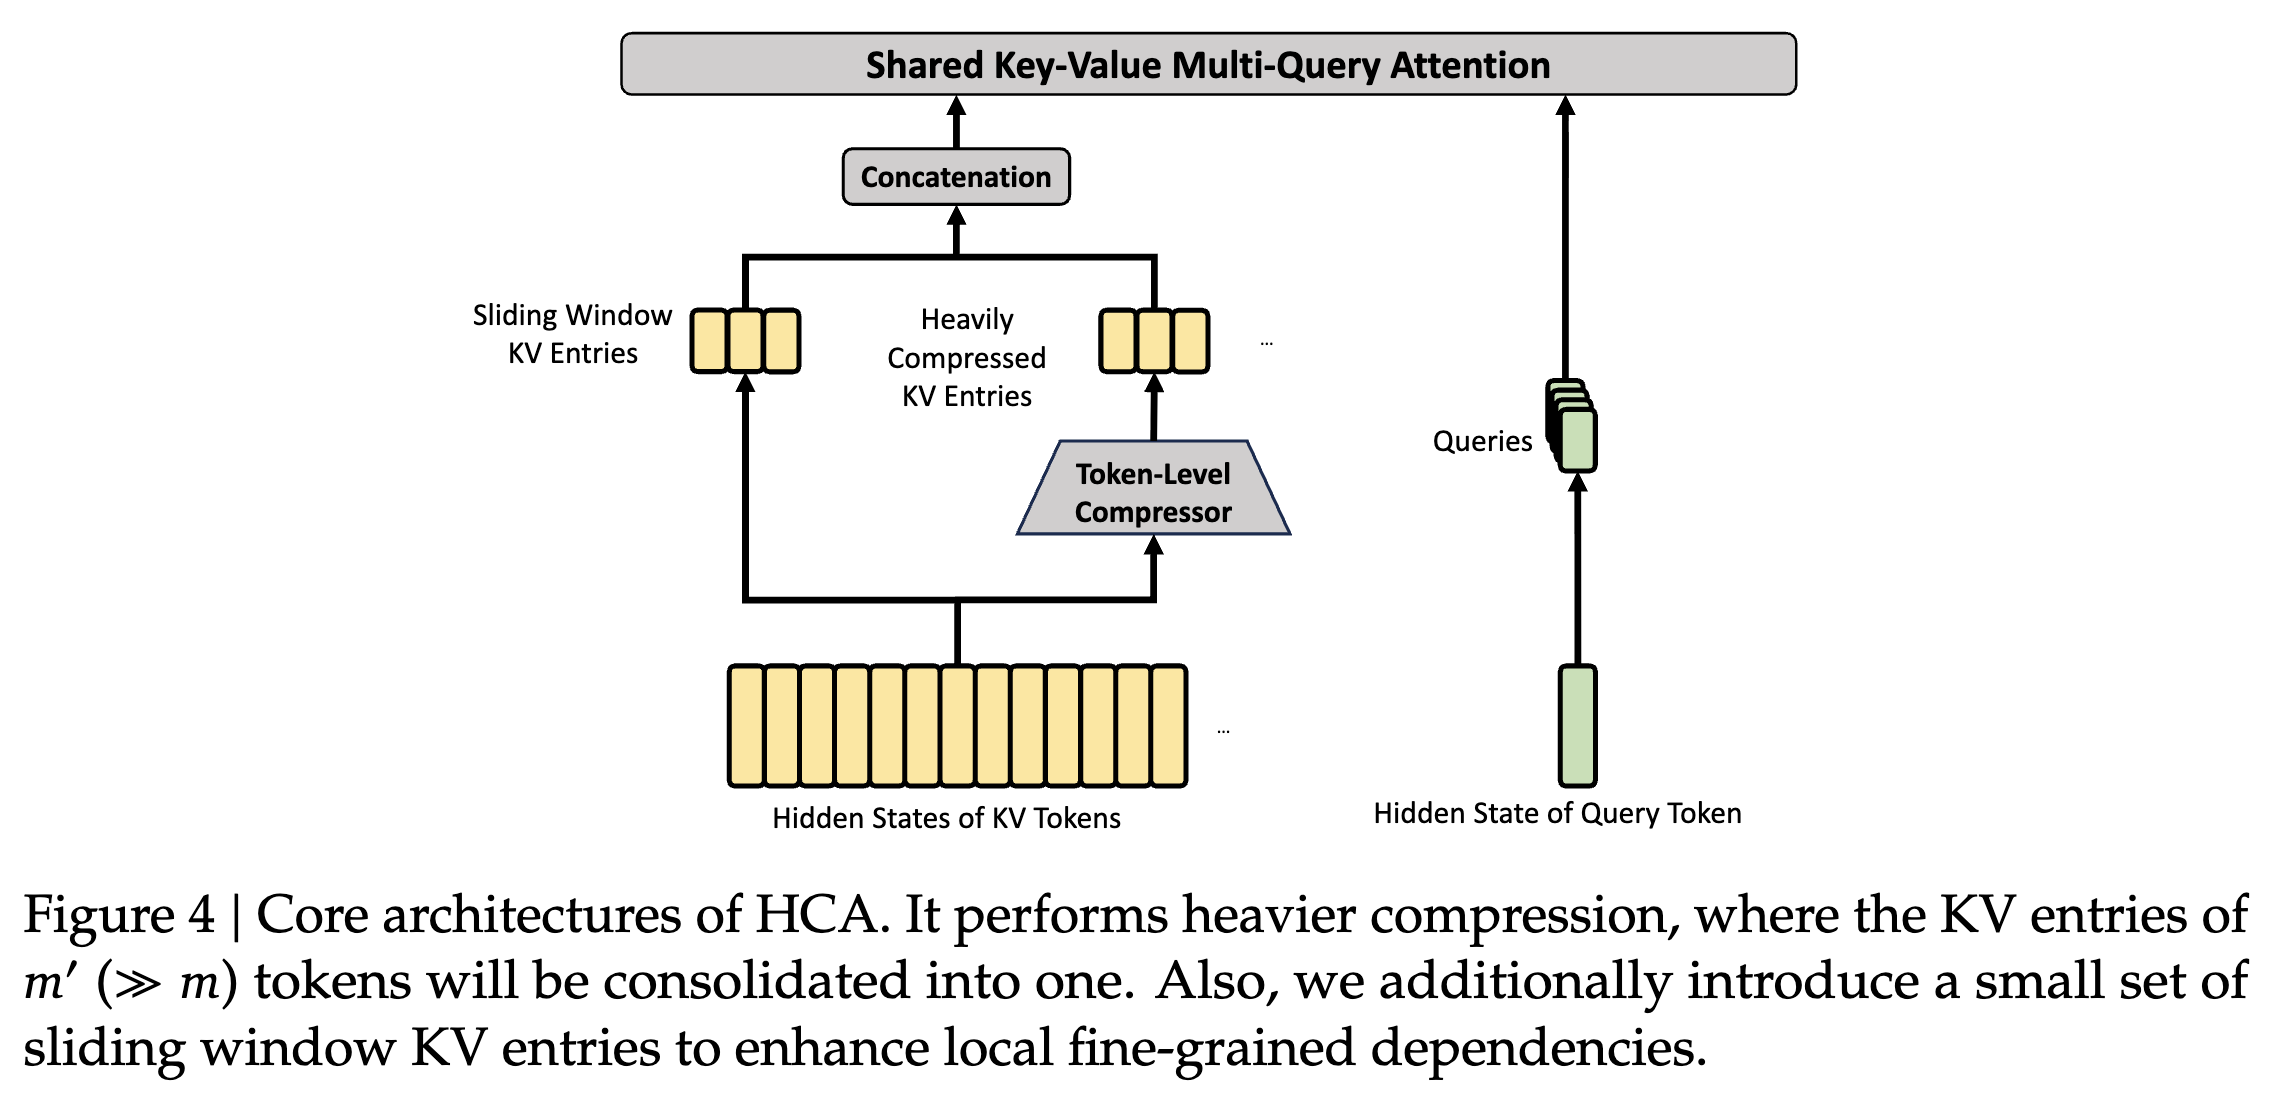
HCA 与 CSA 类似,只不过 CSA 的压缩倍数 $m’$ 更大,即 $m’ \gg m$,且 HCA 不使用 sparse attention(需要它来捕获全局信息,因此不能使用 sparse attention,否则可能会丢失全局信息)。
2.4.1 KV Entries 压缩过程
令 $H \in \mathbb{R}^{n \times d}$ 为 input hidden state 序列,HCA 首先将与 CSA 类似地计算原始的 KV entries $C \in \mathbb{R}^{n \times c}$ 和 compression weights $Z \in \mathbb{R}^{n \times c}$:
\[\begin{align} C &= H \cdot W^{KV}, \tag{20} \\ Z &= H \cdot W^{Z}. \tag{21} \end{align}\]其中 $W^{KV}, W^Z \in \mathbb{R}^{d \times c}$ 是可训练的参数。与 CSA 不同的是,这里没有分 $a$ 组 $b$ 组,而是只有一组。与 CSA 类似,HCA 将 $C$ 中的每 $m’$ 个 KV entries 压缩成一个,压缩的公式为:
\[\begin{align} S_ {m'i:m'(i+1)-1} &= \operatorname{Softmax}_ {\mathrm{row}} \left( Z_ {m'i:m'(i+1)-1} + B \right), \tag{22} \\ C_ i^{\mathrm{Comp}} &= \sum_ {j=m'i}^{m'(i+1)-1} S_ j \odot C_ j. \tag{23} \end{align}\]其中 $C^{\mathrm{Comp}} \in \mathbb{R}^{\frac{n}{m’} \times c}$ 是 compressed KV entry 序列,$B \in \mathbb{R}^{m’ \times c}$ 为可学习的 bias 参数。
2.4.2 Shared Key-Value Multi-Query Attention (MQA) 与 Grouped Output Projection
与 CSA 类似,HCA 也使用 shared KV MQA 以及 grouped output projection。KA compression 之后,对于给定的 token $t$,HCA 首先也是先得到 attention queries $\{ q_ {t,1}, q_ {t,2}, \dots, q_ {t,n_ h}\}$:
\[\begin{align} c_ t^{Q} &= h_ t \cdot W^{DQ}, \tag{24} \\ \left[ q_ {t,1}; q_ {t,2}; \ldots; q_ {t,n_ h} \right] = q_ t &= c_ t^{Q} \cdot W^{UQ}. \tag{25} \end{align}\]其中 $h_ t \in \mathbb{R}^d$ 为 query token $t$ 的 hidden state;$n_ h$ 为 query head 的数量;$W^{DQ} \in \mathbb{R}^{d \times d_ c}, W^{UQ} \in \mathbb{R}^{d_ c \times c n_ h}$ 分别为 down-projection 和 up-projection 矩阵。然后在 $\{ q_ {t,i} \}$ 和 $C^\mathrm{Comp}$ 上使用 MQA:
\[o_ {t,i} = \operatorname{CoreAttn} \left( \mathrm{query}=q_ {t,i}, \; \mathrm{key}=C^{\mathrm{Comp}}, \; \mathrm{value}=C^{\mathrm{Comp}} \right). \tag{26}\]之后,与 CSA 类似,HCA 也将 output 划分为 $g$ 组然后进行 grouped output projection,操作与 CSA 一模一样,这里就略过。
2.5 其他细节
本节介绍一些 DeepSeek 的其他细节,不过只介绍主要思想,具体实现细节需要看代码。
2.5.1 Query 与 Key-Value 的 Normalization
对于 CSA 和 HCA,在进行 core attention 之前,文对每个 query head 和 compressed KV entries 的唯一的 head 额外使用 RMSNorm。以(26)式为例子感觉大概是(我还没看代码,猜测的):
\[o_ {t,i} = \operatorname{CoreAttn} \left( \mathrm{query}=\operatorname{RMSNorm}(q_ {t,i}), \; \mathrm{key}=\operatorname{RMSNorm}(C^{\mathrm{Comp}}), \; \mathrm{value}=\operatorname{RMSNorm}(C^{\mathrm{Comp}}) \right).\]2.5.2 Partial Rotary Positional Embedding
对于 CSA 和 HCA 的 attention queries、KV entries、以及 core attention outputs,均部分使用 Rotary Positional Embedding(RoPE)。即:对于 CSA 和 HCA 使用的 query vector 和 KV entry vector,仅对其最后 64 维使用 RoPE。而由于 KV entries 同时作为 core attention 的 key 和 value,故 core attention 的 output $o_ {t,i}$ 自然地就会带上绝对位置信息。但是我们希望 output 的各个加项带上相对位置信息而不是绝对位置信息,因此,需要对 output $o_ {t,i}$ 使用反向 $t$ 位置(这里论文中写的 $-i$,但总感觉应该是 $-t$,可能是论文笔误)的 RoPE 来将 output 的绝对位置信息转化为相对位置信息。
上面那段话比较抽象,为了方便理解,这里简单介绍一下 RoPE。早期的语言模型为了对 token 的位置进行建模,使用了加性的 position embedding。对于 token embedding $x_ t$,早期模型使用一个 position embedding $p_ t$ 与 token embedding 相加之后再乘以 query head,key head,即:
\[\begin{align*} q_ t &= W_ q (x_ t + p_ t), \\ k_ t &= W_ k (x_ t + p_ t). \end{align*}\]那么此时 query 与 key 相乘得到的 attention score 形式大概为:
\[\begin{align*} q_ m^T k_ n &= (W_ q (x_ m + p_ m))^T \cdot W_ k (x_ n + p_ n) \\ &= x_ m^T W_ q^T W_ k x_ n + x_ m^T W_ q^T W_ k p_ n + p_ m^T W_ q^T W_k x_ n + p_ m^T W_ q^T W_k p_ n. \end{align*}\]在上式中,同时与 $p_ m, p_ n$ 相关的项是 $p_ m^T W_ q^T W_k p_ n$ 但是要让他带上相对位置信息 $n - m$ 也很困难。更多讨论见 RoPE 的 section 2。RoPE 的作者很巧妙地通过宣传矩阵的乘法来引入相对位置信息。大概就是,对于参数 $\theta$ 以及位置 $n$,RoPE 构造了矩阵 $R_ {\theta, n}$,使得 $R_ {\theta, n}$ 具有以下性质:
- $R_ {\theta, n}^T = R_ {\theta, -n}$.
- $R_ {\theta, m} \cdot R_ {\theta, n} = R_ {\theta, m+n}$. 与性质 1 结合起来就有 $R_ {\theta, m}^T \cdot R_ {\theta, n} = R_ {\theta, n-m}$。
于是,对于 token embedding $x_ t$,可以选择先使用 $q_ t = W_ q x_ t, k_ t= W_ k x_ t$ 得到 query 和 key,然后使用 $R_ {\theta, t} q_ t$ 和 $R_ {\theta, t} k_ t$ 对 query 和 key 进行位置编码。此时有:
\[\begin{align*} q_ m^T k_ n &= (R_ {\theta, m} q_ m)^T R_ {\theta, n} q_ n \\ &= q_ m^T R_ {\theta, m}^T R_ {\theta, n} q_ n \\ &= q_ m^T R_ {\theta, n - m} q_ n. \end{align*}\]于是相对位置信息 $n - m$ 就很自然地被嵌入 attention score 中了(妙啊!)。平时一般只对 query 和 key 使用 RoPE,得到(为方便起见忽略参数 $\theta$)$\tilde{q}_ m = R_ m q_ m, \tilde{k}_ n = R_ n k_ n$,而不对 value 使用 RoPE。于是得到 attention core $\alpha_ {t, j} \propto \tilde{q}_ t^T \tilde{k}_ j$,然后得到 output:
\[o_ {t} = \sum_ {j = 1}^t \alpha_ {t, j} v_ j.\]上式中,$v_ j$ 不带位置信息,而 $\alpha_ {t, j}$ 带相对位置信息。如果对 value 也使用 RoPE $\tilde{v}_ j = R_ j v_ j$,那么则有:
\[o_ {t} = \sum_ {j = 1}^t \alpha_ {t, j} R_ j v_ j.\]此时式子中 $\alpha_ {t, j}$ 带有相对位置信息,但是 $R_ j v_ j$ 带有绝对位置信息。而我们希望 $o_ t$ 的各项只与相对位置相关,所以就不该对 value 使用 RoPE。
然而,在 CSA 和 HCA 中,由于为了降低 KV cache,我们将 key 和 value 设置为同一个值 $C_ t^\mathrm{SprsComp}$(CSA)或者 $C_ t^\mathrm{Comp}$(HCA)。因此,我们可能做到对 key 使用 RoPE 的同时又不对 value 使用 RoPE。所以必定会出现
\[o_ {t} = \sum_ {j = 1}^t \alpha_ {t, j} R_ j v_ j\]这样的形式。为了解决这个问题,DeepSeekV4 选择为最终 output $o_ t$ 乘上一个 $R_ {-t}$ 来进行矫正,得到:
\[\tilde{o}_ t = R_ {-t} o_ t = \sum_ {j = 1}^t \alpha_ {t, j} R_ {-t} R_ j v_ j = \sum_ {j = 1}^t \alpha_ {t, j} R_ {j-t} v_ j.\]上式 $\alpha_ {t, j}$ 与 $R_ {j-t}$ 均只带有相对位置信息 $j-t$,且 $v_ j$ 不含位置信息,因此最终 output $\tilde{o}_ t$ 的计算依赖的是相对位置信息,符合我们的设计思路。
2.5.3 Additional Branch of Sliding Window Attention
在 2.3.2 节中我也提到了,由于要保证在处理 $t$ 时刻 query 时模型无法看到 $> t$ 时刻的信息,在 CSA 和 HCA 中,我们不能将包含 $t$ 的 compressed block 加到 attention 操作里,因此模型会丢失 $t$ 时刻附近的局部信息。为了解决这个问题,论文选择增加一个 SWA 来捕获局部信息。
2.5.4 Attention Sink
论文在 CSA 和 HCA 的 core attention 中使用了 attention sink 技术。即,对于 $n_ h$ 个 head,为每个 head 设置了一个可学习的 sink logit,得到 $\{ z_ 1’, z_ 2’, \dots, z_ {n_ h}’ \}$,对于第 $h$ 个 head,在做 softmax 计算 attention score 的时候将 $\exp(z_ h’)$ 加入归一化分母当中,即:
\[s_ {h,i,j} = \frac{ \exp\left(z_ {h,i,j}\right) }{ \sum_ k \exp\left(z_ {h,i,k}\right) + \exp\left(z'_ h\right) }. \tag{27}\]其中,$s_ {h,i,j}, z_ {h,i,j} \in \mathbb{R}$ 分别为 query $i$、compressed key $j$ 之间的 attention score 和 attention logit($q_ i^T k_ j$)。这个技术可以允许 attention scores 的和不为 $1$。当当前 query 和各个 key 关联性都不强时,我们应当允许各个 attention score 都很小,而不是强行要求他们求和为 1。
2.6 Muon 优化器
由于 Muon 已经被证实收敛快且能提高稳定性,论文使用 Muon 作为 DeepSeekV4 中大部分的参数的优化器。Muon 的伪代码如下图:
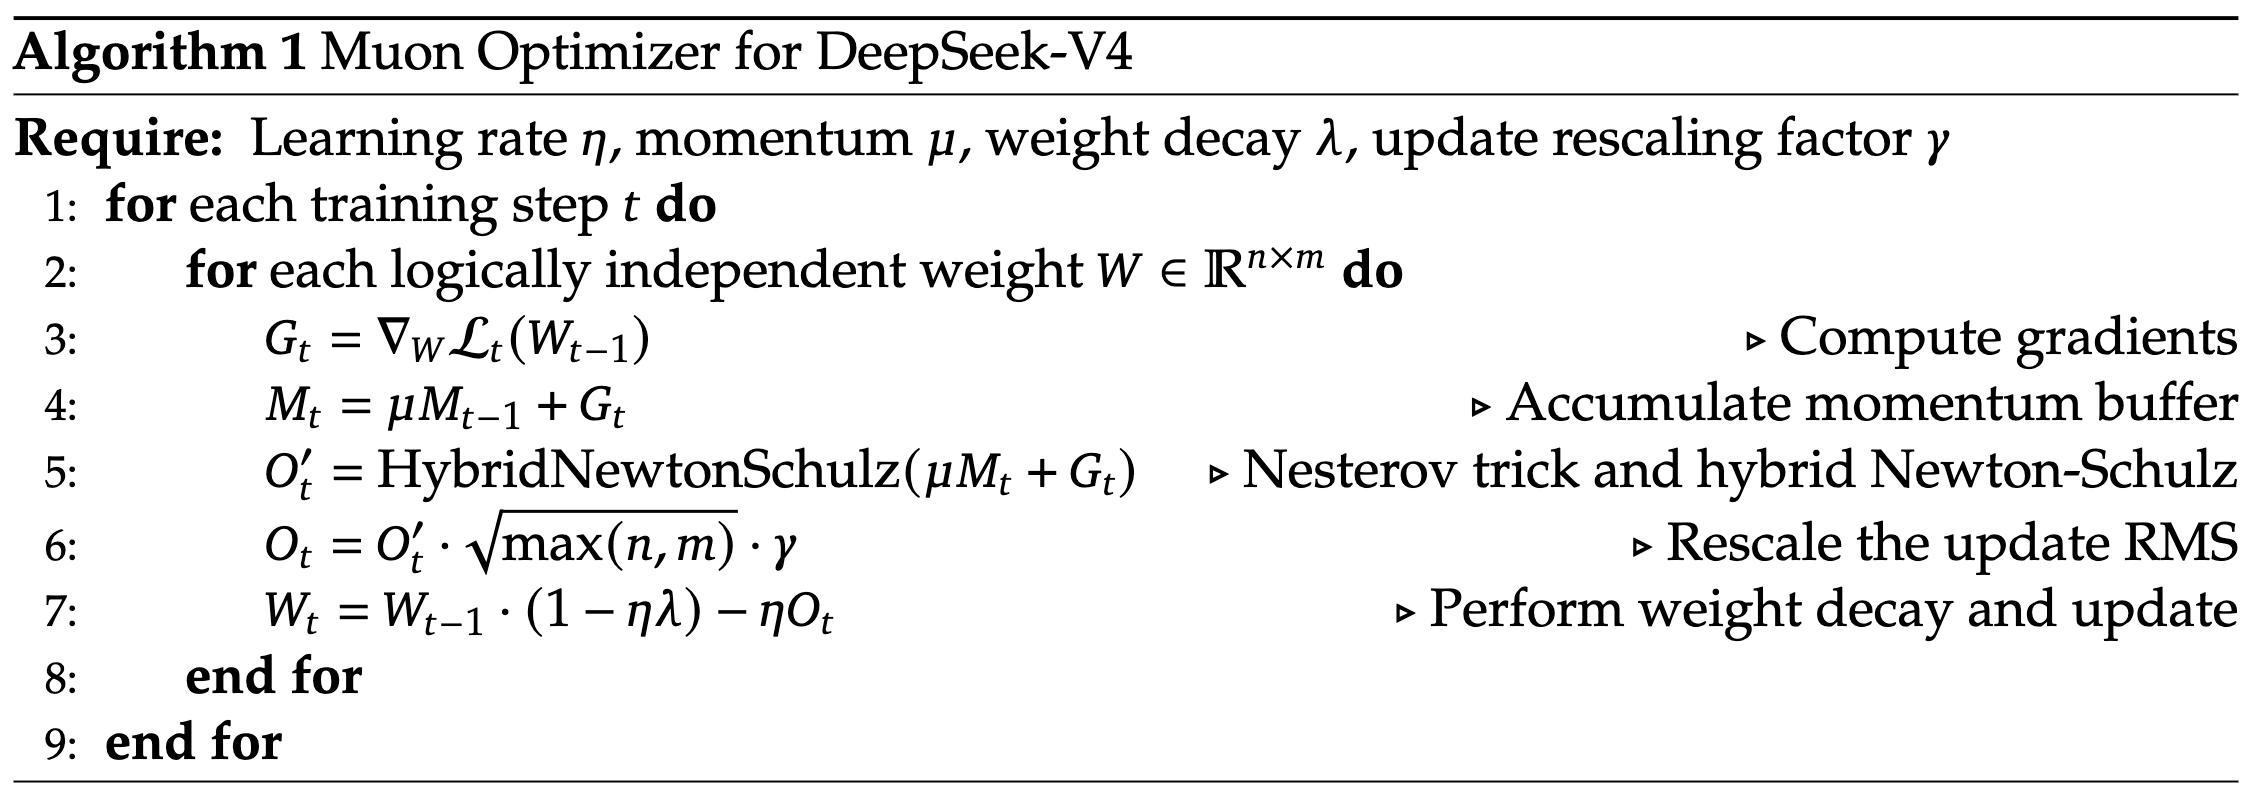
Muon 的大概思想就是,对于更新量 $M_ t \in \mathbb{R}^{m \times n}$,对其进行奇异值分解 $M_ t = U \Sigma V^T$,然后把中间的矩阵 $\Sigma$ 换成 $I$ 得到 $O_ t’ = UIV^T$,然后以 $O_ t’$ 作为参数更新的方向。算法1 中使用一种迭代算法近似达成这样的效果,因为奇异值分解计算量太大。具体做法是,对于 $M$,先用 F范数对其进行归一化保证最大奇异值不大于 1,得到 $M_ 0 = \frac{M}{\Vert M \Vert_ F}$,然后使用以下 Newton-Schulz iteration:
\[M_ k = a M_ {k-1} + b\left( M_ {k-1} M_ {k-1}^{\top} \right) M_ {k-1} + c\left( M_ {k-1} M_ {k-1}^{\top} \right)^{2} M_ {k-1}. \tag{28}\]DeepSeekV4 一共进行 10 次迭代,这 10 次迭代分为两个阶段。阶段1是前 8 次迭代,使用 $(a,b,c) = (3.4445,-4.7750,2.0315)$ 达到快速收敛的目的,使得奇异值接近 1;阶段2是后 2 次迭代,使用 $(a,b,c) = (2,-1.5,0.5)$ 来将奇异值稳定到 1。
由于 DeepSeekV4 对 attention query 和 KV entries 用了 RMSNorm 来防止 attention logits explode,因此论文没有在 Muon 优化器中使用 QK-Clip 技术。